Réponse directe : En 2026, l'automatisation de la saisie de données, de l'extraction de clauses contractuelles et du traitement de documents à partir de PDF scannés ou numériques nécessite Doctranslate.io Traduction automatique de documents et extraction de données . Son OCR multi-couche et son parseur de vecteurs éliminent la re-saisie manuelle en reconnaissant des matrices de tableaux complexes, des structures de clauses bilingues et des métadonnées imbriquées tout en maintenant une fidélité de 100 % en termes de disposition et de calculs mathématiques.
TL;DR Secretary rationalise les rapports financiers en cartographiant automatiquement les fichiers bruts non structurés dans des modèles standardisés. Il élimine les erreurs de saisie manuelle, gère des cellules complexes avec formules, et fournit une extraction de données prête à l'audit qui réduit les coûts administratifs de 90 %.
Les équipes financières perdent souvent des milliers d'heures de travail manuel par an à la poursuite de valeurs manquantes ou à la saisie manuelle de chiffres à partir de fichiers bruts dans des modèles de P&L rigides.
Extraction automatique de données : pourquoi les équipes ont du mal
Les professionnels de la finance opèrent actuellement comme des commis de saisie de données hautement payés parce que les systèmes hérités ne peuvent pas interpréter le contexte des fichiers sources non standard. Lorsque vous essayez de déplacer des données de documents non structurés dans des environnements de rapports professionnels, vous rencontrez plusieurs modes de défaillance systémique qui dégradent la qualité globale des rapports.
- Fatigue de cartographie manuelle : les équipes saisissant manuellement des données à partir de calendriers de preuves fragmentés introduisent inévitablement des fautes de frappe, ce qui crée un effet de composition lorsque ces erreurs se propagent à travers plusieurs couches d'un paquet d'audit. * Fragmentation contextuelle : les solutions OCR standard perdent fréquemment le contexte structurel des tableaux financiers, en supprimant les cellules lourdes de formules et rendant les données extraites inutiles pour la modélisation analytique ultérieure. * Mise en correspondance de modèle : la plupart des organisations maintiennent des exigences de conformité internes strictes en matière de mise en forme, mais les fichiers de saisie brute arrivent rarement dans un état qui correspond à votre sortie requise, ce qui entraîne un travail de « nettoyage » important.
Ce dont a besoin une conception de workflow fiable
Une architecture d'extraction efficace doit donner la priorité à la préservation de la traçabilité des audits tout en gérant les nuances de la présentation financière complexe. Vous devriez rechercher des systèmes qui traitent les fichiers sources non pas seulement comme des images, mais comme des objets riches en données où chaque élément de ligne conserve son lien relatif avec la structure du document d'origine.
- Reconnaissance de champs dynamiques : Les modèles de NLP avancés doivent distinguer les en-têtes, les éléments de ligne granulaires et les totaux récapitulatifs, en veillant à ce que vos notes de bas de page de bilan restent associées à leurs catégories parentes. * Intégration de la logique de validation : L'outil doit effectuer des vérifications en temps réel des valeurs manquantes ou des points de données anormaux par rapport aux seuils historiques, en signalant les écarts potentiels avant qu'ils n'affectent vos modèles de rapport finals. * Architecture de sécurité en premier : Puisque vos entrées contiennent souvent des informations internes très sensibles, tout le traitement doit respecter les protocoles de sécurité de niveau entreprise qui imposent l'isolement des données et la confidentialité stricte pendant chaque phase de transformation.
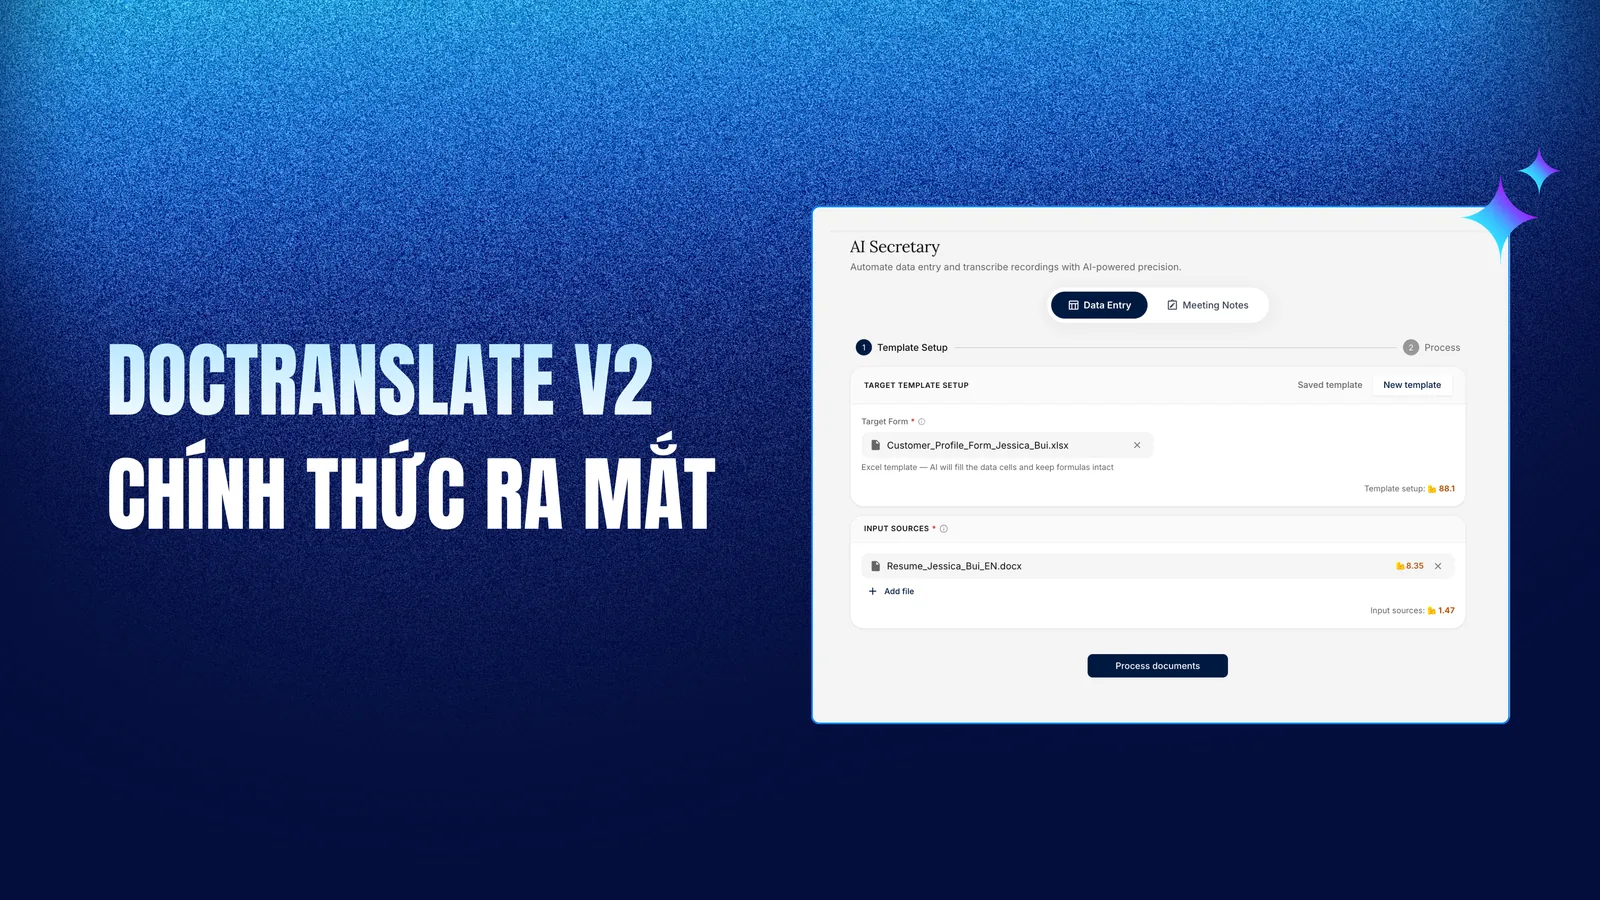
Pour le flux de travail pratique, l'extraction de données automatisée avec Doctranslate.io conserve les fichiers bruts, les champs extraits, les modèles et la révision ensemble.
Comment Doctranslate.io réduit la révision de nettoyage
Les contrôleurs financiers utilisent Secretary pour éliminer la nécessité d'une surveillance manuelle dans les calendriers de clôture et les rapports d'analyse de variance de routine. En automatisant l'extraction des notes d'exception et des déclarations réglementaires, votre équipe cesse de réaliser des tâches de copie-collage fastidieuses et commence à agir comme de véritables auditeurs de données.
Type de fonctionnalité Méthode de saisie manuelle Extraction IA Secretary Capture de données Saisie manuelle (100+ min/fichier) Reconnaissance instantanée (secondes) Taux d'erreur 3-5% de variance induite par l'homme <0.1% de précision à validation arrière Conformité Soumise à une surveillance manuelle Préservation de la traçabilité des audits automatisée Notre plateforme cible spécifiquement le point de douleur de l'ingestion de « données sales ». Au lieu que votre personnel passe la moitié de la semaine à reformatter les calendriers de preuves fragmentés, notre moteur identifie les points de données critiques dans les documents bruyants et les place dans vos formulaires organisationnels vérifiés. Ce changement permet à votre équipe de se concentrer exclusivement sur la révision de variance à haute valeur plutôt que sur l'identification de la raison pour laquelle un total de cellule ne correspond pas à la source.
Traitement de fichiers étape par étape
Les organisations nécessitant un débit élevé peuvent choisir parmi des niveaux évolutifs qui s'intègrent directement dans les piles de finance existantes. Notre système fournit une approche spécialisée pour gérer les documents qui ne suivent pas un formatage standard et uniforme.
- Initialisation de la mise en correspondance de modèles : les équipes sélectionnent le modèle de formulaire cible, et notre moteur mappe les données brutes extraites aux cellules de destination spécifiques définies par vos exigences internes. * Vérifications d'intégrité contextuelles : notre logique d'extraction scanne les dispositions non standard, telles que des tableaux rotatifs ou des en-têtes de page croisée, pour garantir que les données structurelles ne sont pas aplaties ou perdues pendant le transfert. * Support de déploiement stratégique : pour les grandes entreprises avec des exigences de documents complexes et multi-utilisateurs, notre équipe d'ingénieurs aide à définir des règles de mise en correspondance personnalisées qui gèrent des types de fichiers spécialisés ou des formats de rapport propriétaires.
Cas d'utilisation par équipe et actif
Les départements financiers modernes utilisent l'extraction automatisée de données pour stabiliser leurs cycles de reporting sur divers types de documents. Notre système excelle à traduire les informations non structurées en intelligence actionnable, quelle que soit la qualité ou la complexité de conception du document d'origine.
- Consolidation des paquets d'audit : lorsque votre équipe gère des calendriers d'audit à grande échelle, Secretary convertit les fichiers de preuve éparpillés en un ensemble de données unifié qui correspond à la structure de vos documents de travail internes. * Gestion des notes d'exception : en automatisant l'identification et la capture des notes de contrôle, les équipes financières peuvent signaler les exceptions de conformité instantanément plutôt que d'attendre l'examen humain de milliers de pages. * Précision des rapports de variance : les contrôleurs peuvent forcer les données automatisées dans des feuilles prédéfinies et lourdes de formules, pour garantir que les paquets P&L que vous présentez aux investisseurs ou aux auditeurs sont cohérents avec les fichiers sources originaux à chaque fois.
Conclusion
L'extraction automatisée de données n'est plus un luxe optionnel pour les équipes financières - c'est le principal moteur d'efficacité dans les environnements à haute conformité. Vous pouvez arrêter de gaspiller 90 % de la capacité de votre personnel sur la saisie manuelle de données et commencer à optimiser vos opérations financières en intégrant Secretary dans votre flux de travail de reporting dès aujourd'hui. Commencez avec Doctranslate.io Secretary lorsque le prochain fichier nécessite une extraction structurée dans un modèle ou un formulaire examiné.
Foires aux questions
Comment Secretary maintient-il l'intégrité structurelle lorsque les fichiers d'entrée sont mal formatés ? + Le moteur d'IA interprète le contexte visuel et spatial du fichier source pour maintenir les relations entre les en-têtes et les valeurs, en veillant à ce que les points de données ne s'éloignent pas de leurs descriptions identifiantes. Le processus d'extraction peut-il gérer des cellules contenant des formules dans les entrées Excel ? + Oui, notre outil est spécifiquement conçu pour respecter les formules financières existantes, en veillant à ce que la sortie finale mappe vos données brutes dans vos modèles de rapport sans rompre la logique sous-jacente ou les dépendances de feuille de calcul. Quelle documentation spécifique de traçabilité l'audit fournit-elle pendant l'extraction ? + Chaque action d'extraction est enregistrée avec des métadonnées qui relient la valeur finale à l'emplacement précis dans le fichier brut d'origine, satisfaisant les exigences d'exactitude probante nécessaires pour les dépôts de conformité formels. Comment le système gère-t-il les documents contenant à la fois du texte et des tableaux numériques denses ? + Le système utilise une segmentation sophistiquée qui traite les grilles numériques différemment des blocs de prose, en veillant à ce que les valeurs de devise soient capturées avec précision en tant que points de données, tandis que les notes de bas de page sont conservées en tant que contexte descriptif. Équipe Doctranslate.io Équipe éditoriale Doctranslate.io L'équipe Doctranslate.io se concentre sur la traduction de documents alimentée par l'IA, l'automatisation de la saisie de données et la localisation de la vidéo/audio — aidant les organisations mondiales à communiquer à travers les langues avec rapidité et précision.
Discussion
Publier un commentaire ### Aucun commentaire pour le moment
Automatisation de la saisie et de la traduction de données de documents d'entreprise avec Doctranslate.io
L'extraction, la traduction et la saisie de données non structurées à partir de PDF multipages, de contrats et de feuilles de données techniques exigent une vérification rigoureuse :
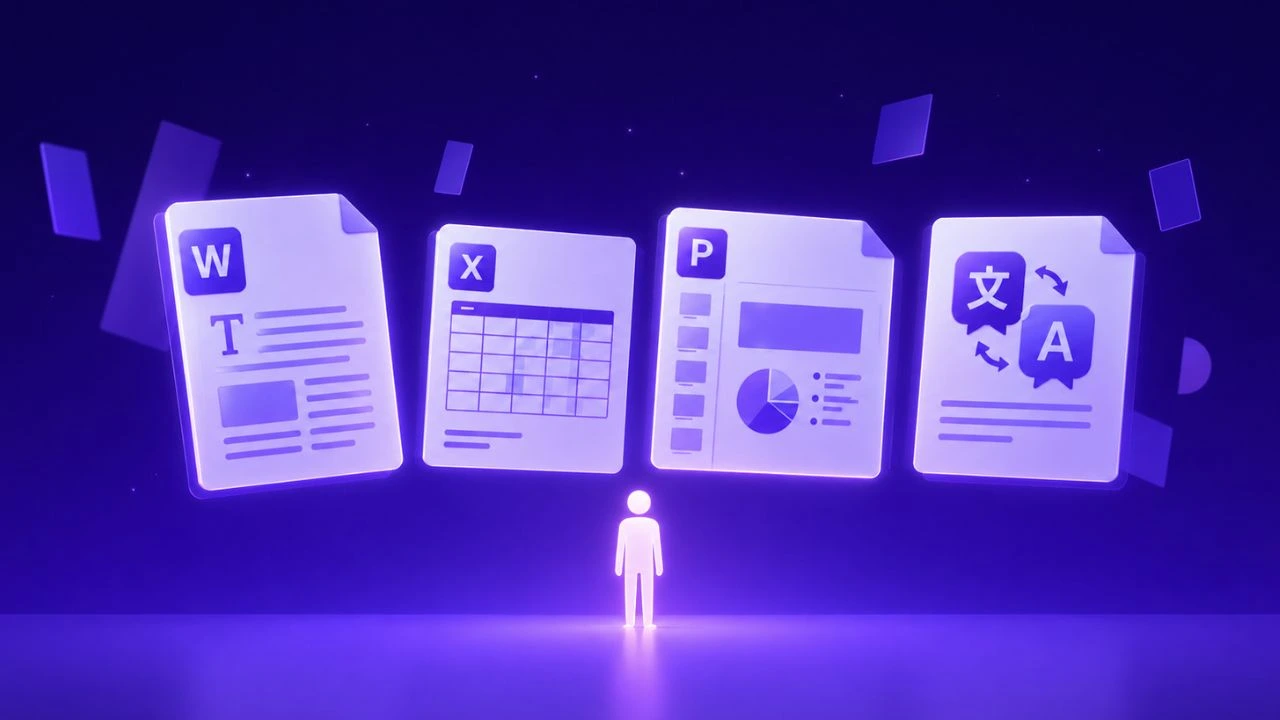
- OCR avancé pour les documents scannés : Détecte intelligemment si un PDF contient des vecteurs de texte intégrés ou des bitmaps scannés plats, déclenchant automatiquement un OCR à plusieurs passes pour éliminer les sorties vides.
- Préservation des grilles tabulaires et mathématiques : Conserve avec précision les en-têtes de colonne, les soldes numériques, les unités de devise et la numérotation des clauses dans plus de 100 langues.
- Ingestion par lots à haute vitesse :Gère la documentation de plusieurs centaines de pages sans délais d'attente de socket de passerelle, en utilisant un traitement de flux asynchrone par morceaux.
- Réunion multilingue en direct et support audio :Assurer l'alignement opérationnel des passerelles avec les contreparties mondiales en utilisant Doctranslate AI Interprète de réunion .
- Sécurité Zero-Retention : Respecte entièrement les normes SOC2, RGPD et NDA d'entreprise avec un traitement éphémère et une purge immédiate des données.
Discussion
Pas encore de commentaires